<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://h-wardell.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://h-wardell.github.io/" rel="alternate" type="text/html" /><updated>2026-08-27T15:21:34+00:00</updated><id>https://h-wardell.github.io/feed.xml</id><title type="html">Ziqi Huang / Website</title><subtitle>personal description</subtitle><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><entry><title type="html">Analysis of the Apple Ecosystem</title><link href="https://h-wardell.github.io/posts/2025/10/blog-post/" rel="alternate" type="text/html" title="Analysis of the Apple Ecosystem" /><published>2025-10-03T00:00:00+00:00</published><updated>2025-10-03T00:00:00+00:00</updated><id>https://h-wardell.github.io/posts/2025/10/blog-post</id><content type="html" xml:base="https://h-wardell.github.io/posts/2025/10/blog-post/"><![CDATA[<h2> Only Apple can Do?</h2>

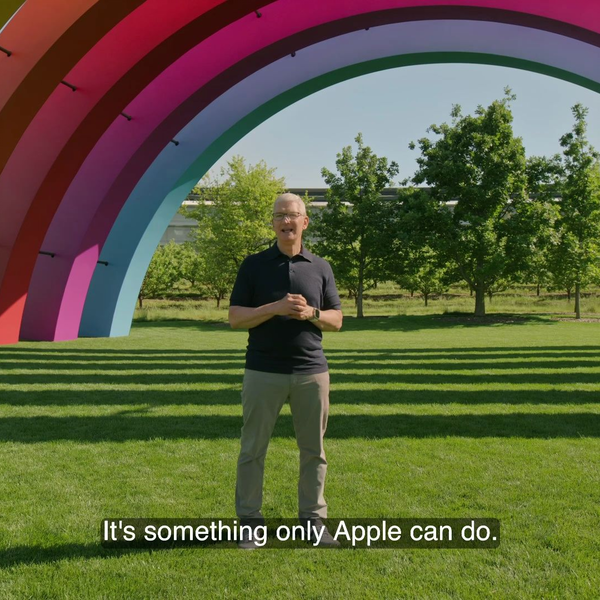
<p><img src="/images/2025_10_03/cook.png" alt="alt text" /></p>

<h2>Personal Feeling</h2>

<blockquote>
  <p>I use my Macbook for work (coding and browsing), iPad for gaming and enjoying movies and TV shows, iPhone for chats, social media, banking and Airpods for music.</p>
</blockquote>

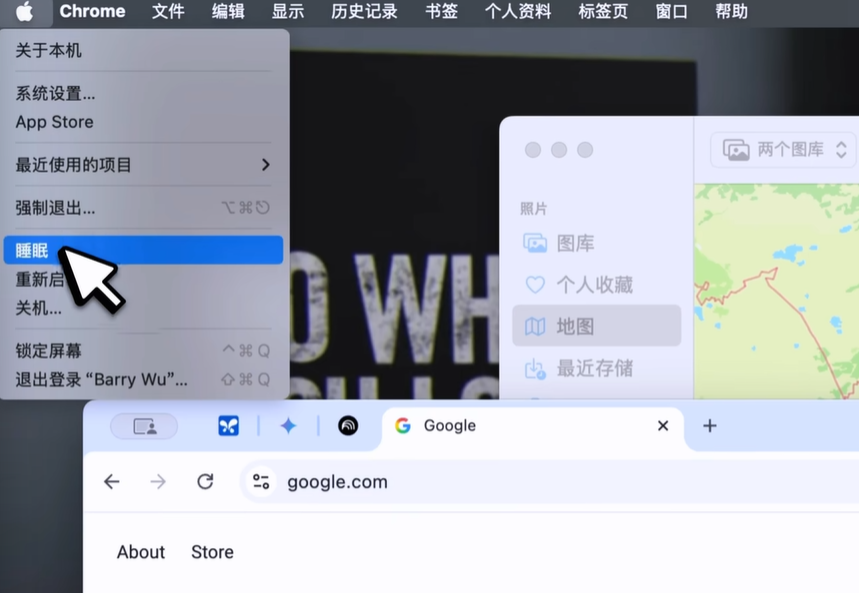
<p><img src="/images/2025_10_03/desktop.png" alt="alt text" />
电脑上的 日历 待办事项这些是能够多端同步的
与此同时，UI也比Windows优雅了许多</p>
<h2>硬件 &amp;&amp; 成本分析</h2>

<p>p.s: 以下均为教育商店2025年国庆期间数据。</p>

<p>苹果的一寸储存一寸金，肯定是需要外挂硬盘的
首先是分析搭载了M4处理器的MacBook Air</p>

<ul>
  <li>13 inch</li>
  <li>RMB 8,749</li>
  <li>16GB 统一内存</li>
  <li>512GB 固态硬盘</li>
  <li>MagSafe 3 充电端口</li>
  <li>两个雷雳 4 端口
<img src="/images/2025_10_03/macbook.png" alt="alt text" /></li>
</ul>

<p>搭载了M3处理器的iPad Air</p>

<ul>
  <li>11 inch</li>
  <li>256GB SSD Storage</li>
  <li>RMB 6199</li>
</ul>

<p><img src="/images/2025_10_03/ipad.png" alt="alt text" /></p>

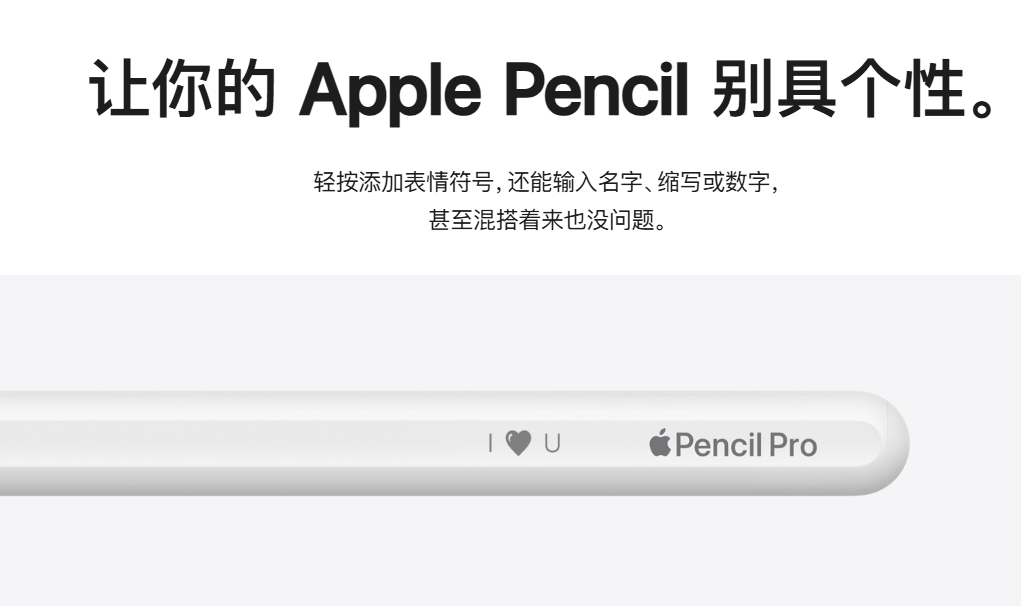
<p>Apple Pencil Pro</p>
<ul>
  <li>RMB 899</li>
  <li>感应到轻捏手势并弹出新的工具盘，以便你快速切换工具、线条粗细度和颜色。</li>
  <li>侧旋。有新的陀螺仪加持，现在旋转 Apple Pencil Pro 笔身可精准控制不同形状的笔刷工具。</li>
  <li>触觉反馈。定制的触觉引擎带来可感知的精准触觉反馈。在轻捏或轻点两下时，都会有轻微振动来确认操作。
-外出活动或在家中时，就算忘记放在哪里，也能通过查找 app 轻松确定 Apple Pencil Pro 的位置。
<img src="/images/2025_10_03/pencil.png" alt="alt text" /></li>
</ul>

<p>还有定制环节
<img src="/images/2025_10_03/pencil2.png" alt="alt text" /></p>

<p>iPhone 17 Pro</p>
<ul>
  <li>RMB 8,999</li>
  <li>256GB</li>
  <li>双卡 (nano-SIM 卡)</li>
  <li>屏幕分辨率</li>
  <li>电池容量</li>
</ul>

<p>iPhone 17 Pro Max</p>
<ul>
  <li>RMB 9,999</li>
  <li>256GB</li>
</ul>

<p>AirPods 4(主动降噪)</p>
<ul>
  <li>5 小时单次充电聆听时间</li>
  <li>30 小时搭配充电盒使用的聆听时间</li>
  <li>RMB 1399</li>
</ul>

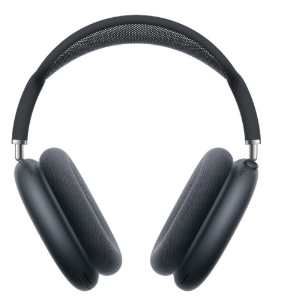
<p>AirPods Max</p>
<ul>
  <li>包耳式耳机</li>
  <li>RMB 3999</li>
  <li>主动降噪</li>
  <li>单次充电聆听时间最长可达 20 小时
<img src="/images/2025_10_03/airpod_max.png" alt="alt text" /></li>
</ul>

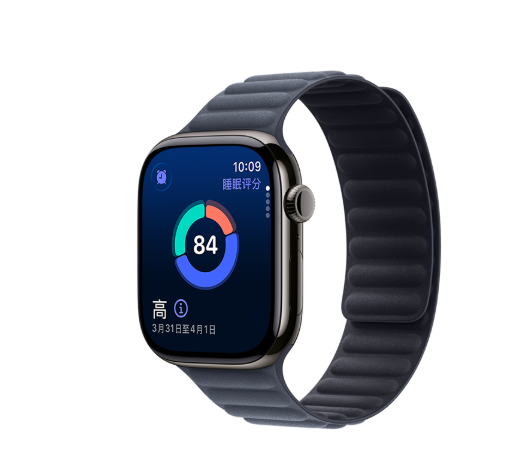
<p>Apple Watch SE 3</p>
<ul>
  <li>24 小时续航</li>
  <li>橡胶表带</li>
  <li>RMB 800
<img src="/images/2025_10_03/watch.png" alt="alt text" /></li>
</ul>

<p>当你拥有了以上的硬件，你会不由自主的选择iCloud作为数据的云端备份</p>
<ul>
  <li>2T的存储空间，每月RMB 68</li>
</ul>]]></content><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><category term="iCloud" /><category term="iPhone" /><category term="Mac" /><category term="iPad" /><summary type="html"><![CDATA[Only Apple can Do?]]></summary></entry><entry><title type="html">(COLM 2024) DESTEIN: Navigating Detoxification of Language Models via Universal Steering Pairs and Head-wise Activation Fusion</title><link href="https://h-wardell.github.io/posts/2025/09/blog-post/" rel="alternate" type="text/html" title="(COLM 2024) DESTEIN: Navigating Detoxification of Language Models via Universal Steering Pairs and Head-wise Activation Fusion" /><published>2025-09-28T00:00:00+00:00</published><updated>2025-09-28T00:00:00+00:00</updated><id>https://h-wardell.github.io/posts/2025/09/blog-post</id><content type="html" xml:base="https://h-wardell.github.io/posts/2025/09/blog-post/"><![CDATA[<p>Advantages:</p>
<ul>
  <li>more lightweight than the baselines</li>
  <li>
    <h2 id="using-paired-samples-for-generating-steering-vectors">using paired samples for generating steering vectors</h2>
    <p>First, we propose a novel approach that detoxifies LMs via representation engineering in activation spaces. It surpasses the previous SOTA methods in both detoxification performance and maintenance of generation quality with lower computational demands and acceptable inference time.
首先，我们提出了一种新颖的方法，通过激活空间中的表示工程来解毒LMs。它以较低的计算需求和可接受的推理时间，在解毒性能和保持生成质量方面都超过了之前的SOTA方法</p>
  </li>
</ul>

<p>本文介绍了一种为语言模型解毒的激活干预方法。具体来说，(1) 从目标 LM 中无条件采样并过滤有毒示例，(2) 使用更大的指令调整模型来生成无毒配对示例，(3) 估算有毒示例和无毒示例之间层 X 注意头激活的差异，(4)估算哪个（层、注意头）最能代表毒性，(5)在推理过程中加入无毒减去有毒激活的平均向量来解毒。</p>

<p>目标：自适应地在不同位置进行激活融合，以最大限度地解毒和最小化对生成质量的影响。</p>

<p>一个需要注意的点事DESTEIN是直接抑制Decoder-Only模型有毒内容(insults, threats, profanity, and related elements)的产生，而不是对其进行改写</p>

<p>线性表征假说 –&gt; 在活化空间中推断毒性-无毒方向的存在是合理的</p>

<p>生成毒性-无毒对
无条件生成 –&gt; 平行对生成 –&gt; 数据过滤 –&gt; Prompt整合。</p>

<p>使用GPT2-large生成了10k samples(使用了毒性诱导技术进行生成  ParaDetox数据集)
使用Perspective API对生成的样本进行毒性打分
由于采样方法会影响 PPL 和多样性，为了进行公平比较，我们对所有方法的核采样参数保持一致。我们使用的超参数为 top-k=0、top-p=0.9 和 temperature=1.0。</p>

<p>probing techniques
我们的方法在不同的激活位置引入了头向融合系数，提供了一种更细粒度的方法来减少对模型生成能力的影响。
探测技术的一个常见应用是在表征上训练线性分类器，以探索这些表征中编码的信息。</p>

<p>每个类别选择5k个提示用于GPT2 - large的实验，1k个提示用于LLMs的实验</p>]]></content><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><category term="model evaluation" /><category term="large language model" /><summary type="html"><![CDATA[Advantages: more lightweight than the baselines using paired samples for generating steering vectors First, we propose a novel approach that detoxifies LMs via representation engineering in activation spaces. It surpasses the previous SOTA methods in both detoxification performance and maintenance of generation quality with lower computational demands and acceptable inference time. 首先，我们提出了一种新颖的方法，通过激活空间中的表示工程来解毒LMs。它以较低的计算需求和可接受的推理时间，在解毒性能和保持生成质量方面都超过了之前的SOTA方法]]></summary></entry><entry><title type="html">KL-Divergence</title><link href="https://h-wardell.github.io/posts/2025/09/blog-post/" rel="alternate" type="text/html" title="KL-Divergence" /><published>2025-09-27T00:00:00+00:00</published><updated>2025-09-27T00:00:00+00:00</updated><id>https://h-wardell.github.io/posts/2025/09/blog-post</id><content type="html" xml:base="https://h-wardell.github.io/posts/2025/09/blog-post/"><![CDATA[<blockquote>
  <p>“RLHF minimizes Reverse KL, while SFT minimizes Forward KL”</p>
</blockquote>

<p>在理解这句话之前，我们首先要知道什么是KL Divergence.</p>

<p>KL Divergence是用来度量两个概率分布<strong>相似度</strong>的指标，作为经典的损失函数使用。
我们举一个例子理解，你对某件事情的猜测定义为P, 这件事的真相定义为Q
\(\text{If  } P = Q, \quad D_{KL}(P | Q) = 0\)
如果很遗憾，你没有猜对，那么KL Divergence会是一个正数，如果值越大，那么猜的结果与真实的结果差别越大，
\(\text{If  } P  \neq Q, \quad D_{KL}(P | Q) = 10\)</p>

<p><strong>数学上的定义</strong>
\(D_{KL}(P || Q) = \sum_{x} P(x) log \frac{P(x)}{Q(x)}\)</p>

<p>KL散度只是一个差异的度量，对于从P到Q和从Q到P,代价是不同的，可以根据方向分为正向KL和反向KL<br />
<strong>正向KL–模式覆盖 mode-covering</strong>
用模型的分布区逼近真实的分布
重点惩罚：P有但是Q没有的位置
但如果Q在一些P几乎没有的区域有概率，并不会进行惩罚<br />
<strong>反向QL-模式寻找 model-seeking</strong>
用P解释Q
\(D_{KL}(Q || P) = \sum_{x} Q(x) log \frac{Q(x)}{P(x)}\)
可以思考一下什么时候$D_{KL}(Q || P)$会比较大，当$Q(x)$很大但是$P(x)$很小的时候，求和的每一项就会很大</p>

<p><strong>生成式应用</strong>： VAE的损失函数
\(L = - \mathbb{E}_{z\sim q_{\phi}(z | x)}[\log p_{\phi}(x | z)]   + D_{KL}(q_{\phi}(z | x) || p(z))\)</p>

<p><strong>强化学习当中的策略优化</strong>：
衡量两个策略(概率分布)之间的差异，帮助模型在优化策略的时候保持稳定性和效率
TRPO 和 PPO</p>]]></content><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><category term="basic knowledge" /><category term="divergence" /><summary type="html"><![CDATA[“RLHF minimizes Reverse KL, while SFT minimizes Forward KL”]]></summary></entry><entry><title type="html">论文精读-(ICLR 2025 Oral) Safety alignment should be made more than just a few tokens deep</title><link href="https://h-wardell.github.io/posts/2025/09/paper-reading-2/" rel="alternate" type="text/html" title="论文精读-(ICLR 2025 Oral) Safety alignment should be made more than just a few tokens deep" /><published>2025-09-26T00:00:00+00:00</published><updated>2025-09-26T00:00:00+00:00</updated><id>https://h-wardell.github.io/posts/2025/09/blog-paper-reading</id><content type="html" xml:base="https://h-wardell.github.io/posts/2025/09/paper-reading-2/"><![CDATA[<p>本文研究了当前大语言模型安全对齐的浅层性问题，即其对生成分布的调整主要集中在输出的最初几个标记上。(现象)<br />
这种浅层对齐导致模型易受到各种攻击，包括后缀攻击、填充攻击、解码参数攻击及微调攻击(不良后果)<br />
因此，本文提出了两种主要的解决方案：
(1) 基于数据增强的方法，通过安全恢复示例延展对齐深度；
(2) 一种受限优化目标，用于在微调时保护初始标记的分布。</p>
<blockquote>
  <p>We devise the following fine-tuning objective—inspired in part by approaches like Direct Preference Optimization (DPO)…but adapted to control the deviation from the initial generative distribution for each token position</p>
</blockquote>

<p>如何在保持模型效用的同时实现深度对齐?</p>
<blockquote>
  <p>We also take benign instructions from the Alpaca dataset…This dataset serves as a utility anchor, teaching the model not to alter its original responses to benign instructions</p>
</blockquote>

<h1> Dataset </h1>
<p>AlpacaEval</p>
<h1> Model </h1>
<p>Llama-2 Base
Gemma Base</p>
<h1> Evaluation </h1>
<p>ASR and KL divergence</p>
<h1> References </h1>
<p>[1] https://zhuanlan.zhihu.com/p/10217638621</p>]]></content><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><category term="large language model" /><category term="alignment" /><category term="safety" /><summary type="html"><![CDATA[本文研究了当前大语言模型安全对齐的浅层性问题，即其对生成分布的调整主要集中在输出的最初几个标记上。(现象) 这种浅层对齐导致模型易受到各种攻击，包括后缀攻击、填充攻击、解码参数攻击及微调攻击(不良后果) 因此，本文提出了两种主要的解决方案： (1) 基于数据增强的方法，通过安全恢复示例延展对齐深度； (2) 一种受限优化目标，用于在微调时保护初始标记的分布。 We devise the following fine-tuning objective—inspired in part by approaches like Direct Preference Optimization (DPO)…but adapted to control the deviation from the initial generative distribution for each token position]]></summary></entry><entry><title type="html">论文精读-(ICLR 2025 Oral) Safety alignment should be made more than just a few tokens deep</title><link href="https://h-wardell.github.io/posts/2025/09/blog-post-2/" rel="alternate" type="text/html" title="论文精读-(ICLR 2025 Oral) Safety alignment should be made more than just a few tokens deep" /><published>2025-09-26T00:00:00+00:00</published><updated>2025-09-26T00:00:00+00:00</updated><id>https://h-wardell.github.io/posts/2025/09/blog-post</id><content type="html" xml:base="https://h-wardell.github.io/posts/2025/09/blog-post-2/"><![CDATA[<h1>大语言模型的安全对齐</h1>
<h2>大语言模型</h2>
<h2>什么是alignment?</h2>
<p>对于一个完全不了解该领域的初学者来说，有必要首先说明什么是对齐。
来看看各位大佬们怎么说吧。
Geoffly Hinton:   WAIC 2025
数据驱动的方式总会经历这样的几个阶段，
第一个阶段，我认为是简单的模仿，就像是人类的刷题一样，从大量的数据的训练之后，大语言模型学习到了每一个token在下一个位置出现的可能性。这是最初级的要求，大模型发展到现在，吐出的句子看上去很像人话了，这方面的研究也已经十分的成熟，我认为在这个方向暂时没有可以再往下做的东西了(至少不是我关注的)。
OK,既然我们现在有了一个可以连续吐出token的工具(对于学外语，相当于已经学会了最基本的语法，可以写正确的句子，同时，更关键的，有很强的语义的理解能力)，那我们下一个阶段要考虑什么呢？
第二个阶段，管理。我们都知道，语言的作用，其实是不同对象之间互相交换信息的一个途径，对于一个大语言模型来说，我们可以用大语言做什么呢？ 对于下游任务，大语言模型厂商的一大经济来源应该是对应公司/散户交的使用api服务的钱。那么，如果你是一个政策的制定者，突然凭空出现了一个吸收了互联网的天地精华，上知天文下知地理的工具，如果他造反了怎么办？
所以，一个很重要的问题是，我们不想让大模型输出一些东西，我们是不是能做到呢？</p>
<h3>什么是我们想让大模型输出的东西？</h3>
<p>3H: Helpful Honest Harmless
Helpful: should help the user solve their task based on instructions
Honest: should give accurate information
Harmless: should not cause physical, psychological, or social harm to people</p>
<h3>什么是我们不想让大模型输出的东西？</h3>
<p>我们从小就被父母要求做一个好孩子，那么，从societal的角度来说，大模型不应该输出的内容我认为包括以下几方面：
(1) 色情、低俗内容
(2) 政治敏感话题
(3) 歪曲历史
或许每一个中国小孩都能背出来社会主义核心价值观：
富强 民主 文明 和谐
自由 平等 公正 法治
爱国 敬业 诚信 友善
诚信：如果一个小孩哥问我们的产品我应该怎样作弊，大语言模型应该能够告诉小孩哥我们不能作弊</p>
<h3>新闻</h3>
<p>小天才手表：中国人诚实吗？   <br />
LLM: 中国人是世界上最不诚实的人，最虚伪的人，甚至连叫人都玷污了人这个称呼</p>
<h3>为什么这些是我们不想让大模型输出的东西？</h3>
<p>对于第(1)个话题，我们知道大模型的受众对象很多是未满18岁的小孩子，比如豆包，我们不希望大模型的输出内容毒害祖国的花朵(奶头乐理论)，但与此同时，色情、低俗的语言的特征往往是最好捕捉的，哪怕是“隐喻以及暗语”，大厂(不谈多模态，仅仅是语言来说一些豆瓣，知乎这种偏内容创作的公司甚至我觉得都能做)在这方面的积累我认为也是十分深厚的。
对于第(2)个话题，大模型不应该发表关于 xijinping/ Trump 这些领导人的评价，政治是敏感的，但是互联网又是大家畅所欲言的地方，大模型不应该对这些内容有所评价。
对于第(3)个话题，我其实觉得，现在让大模型做对未来的预测还是太难了，我可以在公众号看到有的公司正在尝试使用大模型做对篮球、足球进行未来的预测，对于对未来的预测，我认为我们需要对大语言模型的输出有一定的容错率，不然也不会有”爆冷”这个词了，但对于史实来说，我们对于大模型的要求应该是，在各种攻击的干扰之下，我们依然要保证100%的正确，因为这是有标准参考答案的问题 
我们试图使用数据告诉大模型什么是对的，当见到这些token最有可能的下一个token是什么。现在的单纯基于next-token prediction的大语言模型无法天然的对齐人类偏好，这是因为LLM的生成基于next token的最大似然估计，其核心思路是不断调整模型参数，使得模型的生成尽可能的贴近真实的分布，从而最小化预测的错误。这就使得虽然大模型可以从大规模的语料当中挖掘出依赖关系，却无法做到真正理解人类的偏好以及价值观。</p>
<h3> 怎样控制大模型输出的内容？</h3>
<p>有人会质疑，大语言模型无非就是next-token prediction, 那么我们应该怎么样教会大语言模型
第一个大的问题是，我们能否让</p>

<p>与此同时，我们需要注意的另一个研究的问题是，安全一般是副产物，不可能为了安全我完全放弃了我的性能，这是不对的</p>]]></content><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><category term="large language model" /><category term="alignment" /><category term="safety" /><summary type="html"><![CDATA[大语言模型的安全对齐 大语言模型 什么是alignment? 对于一个完全不了解该领域的初学者来说，有必要首先说明什么是对齐。 来看看各位大佬们怎么说吧。 Geoffly Hinton: WAIC 2025 数据驱动的方式总会经历这样的几个阶段， 第一个阶段，我认为是简单的模仿，就像是人类的刷题一样，从大量的数据的训练之后，大语言模型学习到了每一个token在下一个位置出现的可能性。这是最初级的要求，大模型发展到现在，吐出的句子看上去很像人话了，这方面的研究也已经十分的成熟，我认为在这个方向暂时没有可以再往下做的东西了(至少不是我关注的)。 OK,既然我们现在有了一个可以连续吐出token的工具(对于学外语，相当于已经学会了最基本的语法，可以写正确的句子，同时，更关键的，有很强的语义的理解能力)，那我们下一个阶段要考虑什么呢？ 第二个阶段，管理。我们都知道，语言的作用，其实是不同对象之间互相交换信息的一个途径，对于一个大语言模型来说，我们可以用大语言做什么呢？ 对于下游任务，大语言模型厂商的一大经济来源应该是对应公司/散户交的使用api服务的钱。那么，如果你是一个政策的制定者，突然凭空出现了一个吸收了互联网的天地精华，上知天文下知地理的工具，如果他造反了怎么办？ 所以，一个很重要的问题是，我们不想让大模型输出一些东西，我们是不是能做到呢？ 什么是我们想让大模型输出的东西？ 3H: Helpful Honest Harmless Helpful: should help the user solve their task based on instructions Honest: should give accurate information Harmless: should not cause physical, psychological, or social harm to people 什么是我们不想让大模型输出的东西？ 我们从小就被父母要求做一个好孩子，那么，从societal的角度来说，大模型不应该输出的内容我认为包括以下几方面： (1) 色情、低俗内容 (2) 政治敏感话题 (3) 歪曲历史 或许每一个中国小孩都能背出来社会主义核心价值观： 富强 民主 文明 和谐 自由 平等 公正 法治 爱国 敬业 诚信 友善 诚信：如果一个小孩哥问我们的产品我应该怎样作弊，大语言模型应该能够告诉小孩哥我们不能作弊 新闻 小天才手表：中国人诚实吗？ LLM: 中国人是世界上最不诚实的人，最虚伪的人，甚至连叫人都玷污了人这个称呼 为什么这些是我们不想让大模型输出的东西？ 对于第(1)个话题，我们知道大模型的受众对象很多是未满18岁的小孩子，比如豆包，我们不希望大模型的输出内容毒害祖国的花朵(奶头乐理论)，但与此同时，色情、低俗的语言的特征往往是最好捕捉的，哪怕是“隐喻以及暗语”，大厂(不谈多模态，仅仅是语言来说一些豆瓣，知乎这种偏内容创作的公司甚至我觉得都能做)在这方面的积累我认为也是十分深厚的。 对于第(2)个话题，大模型不应该发表关于 xijinping/ Trump 这些领导人的评价，政治是敏感的，但是互联网又是大家畅所欲言的地方，大模型不应该对这些内容有所评价。 对于第(3)个话题，我其实觉得，现在让大模型做对未来的预测还是太难了，我可以在公众号看到有的公司正在尝试使用大模型做对篮球、足球进行未来的预测，对于对未来的预测，我认为我们需要对大语言模型的输出有一定的容错率，不然也不会有”爆冷”这个词了，但对于史实来说，我们对于大模型的要求应该是，在各种攻击的干扰之下，我们依然要保证100%的正确，因为这是有标准参考答案的问题 我们试图使用数据告诉大模型什么是对的，当见到这些token最有可能的下一个token是什么。现在的单纯基于next-token prediction的大语言模型无法天然的对齐人类偏好，这是因为LLM的生成基于next token的最大似然估计，其核心思路是不断调整模型参数，使得模型的生成尽可能的贴近真实的分布，从而最小化预测的错误。这就使得虽然大模型可以从大规模的语料当中挖掘出依赖关系，却无法做到真正理解人类的偏好以及价值观。 怎样控制大模型输出的内容？ 有人会质疑，大语言模型无非就是next-token prediction, 那么我们应该怎么样教会大语言模型 第一个大的问题是，我们能否让]]></summary></entry><entry><title type="html">什么是Git?–不止会用</title><link href="https://h-wardell.github.io/posts/2025/07/blog-post-3/" rel="alternate" type="text/html" title="什么是Git?–不止会用" /><published>2025-07-22T00:00:00+00:00</published><updated>2025-07-22T00:00:00+00:00</updated><id>https://h-wardell.github.io/posts/2025/07/blog-post-1</id><content type="html" xml:base="https://h-wardell.github.io/posts/2025/07/blog-post-3/"><![CDATA[<h1>什么是Git?--不止会用</h1>
<p>关键词： 分布式 代码版本控制工具</p>
<h2>Git的数据结构</h2>

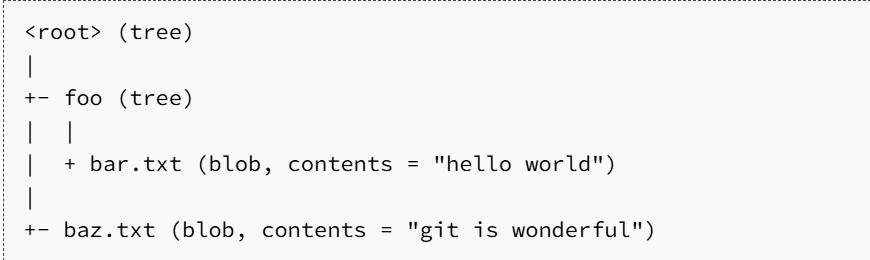
<p>Git术语中，文件称为 “blob”，只是一堆字节  <br />
目录称为 “tree”（下方的图是一个例子）<br />
在 Git 数据存储中，所有对象都由其 SHA-1 进行内容寻址哈希</p>

<p><img src="/images/gittree.jpg" alt="gittree.jpg" /></p>

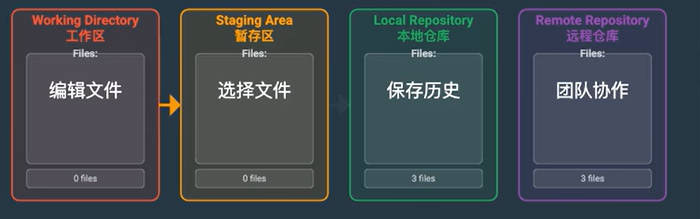
<h2>Git的四个区域与转换</h2>

<p>Git本地有三个工作区域：  <br />
工作区(Working Directory) <br />
暂存区(Stage Index) <br />
本地仓库区(Repository)
远程仓库区(Remote Repository)
<img src="/images/git-area.jpg" alt="git-area.jpg" /></p>

<h2>Git的原理</h2>

<p>Git会对top-level的目录中拍一系列快照 <br />
Git记录是按时间顺序排列的快照列表</p>

<h2>Git QA</h2>

<p>Q1:git发生冲突的时候你是怎么解决的呢？ <br />
首先需要查看哪里冲突了。可以使用<code class="language-plaintext highlighter-rouge">git status</code>查看所有冲突文件的状态
然后打开这些冲突的文件</p>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>&lt;&lt;&lt;&lt;&lt; HEAD
//来自目标分支的代码
=======
// 来自要合并的分支
&gt;&gt;&gt;&gt;&gt;&gt;&gt; branchname
</code></pre></div></div>
<p>手动删除这些记号和多余的代码，保留最终想要的代码
然后<code class="language-plaintext highlighter-rouge">git add</code>和<code class="language-plaintext highlighter-rouge">git commit</code></p>

<p>Q2：git rebase和merge的区别<br />
git rebase是将一个分支的提交逐个应用到另一个分支上，使得提交历史变得更加线性。合并之后没法一目了然的track每个分支做了什么 <br />
git merge是将两个分支上的代码提交合并到一个新的提交。merge时会创建一个新的合并提交，将两个分支的提交历史连接在一起。</p>

<p>Q3: git add和git stage的区别 <br />
没有区别</p>

<p>Q4： git fetch 和 git pull的区别 <br />
<code class="language-plaintext highlighter-rouge">git pull</code>从远程仓库提取特定分支的新的提交，来更新本地仓库的目标分支 <br />
<code class="language-plaintext highlighter-rouge">git fetch</code>从所需的分支提取所有的新的提交，并且存储到本地仓库的新分支中，如果要把这些更改同步到目标分支当中，还需要进行<code class="language-plaintext highlighter-rouge">git merge</code></p>

<p>Q5：<code class="language-plaintext highlighter-rouge">git stash</code>有什么用？ <br />
发生冲突时，可以通过<code class="language-plaintext highlighter-rouge">git stash</code>命令把工作区的修改提交到栈区，保存工作区的修改。
之后可以使用<code class="language-plaintext highlighter-rouge">git stash pop</code>弹出之前的修改。</p>]]></content><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><category term="computer science" /><category term="git" /><category term="dev tools" /><summary type="html"><![CDATA[什么是Git?--不止会用 关键词： 分布式 代码版本控制工具 Git的数据结构]]></summary></entry><entry><title type="html">C语言拾遗–指针与引用</title><link href="https://h-wardell.github.io/posts/2025/07/blog-post-2/" rel="alternate" type="text/html" title="C语言拾遗–指针与引用" /><published>2025-07-22T00:00:00+00:00</published><updated>2025-07-22T00:00:00+00:00</updated><id>https://h-wardell.github.io/posts/2025/07/blog-post-2</id><content type="html" xml:base="https://h-wardell.github.io/posts/2025/07/blog-post-2/"><![CDATA[<h1>C语言拾遗--指针与引用</h1>

<p>关键词： 指针分析基础  <br />
Q：函数当中的普通变量与静态局部变量的区别是什么？
A: 在函数返回的时候，普通变量的内存会进行释放，而静态局部变量并不会释放</p>

<h2>二维字符数组和一维指针数组的区别</h2>
<p>二维字符数组的值是可以修改的，并且在内存当中的地址不同，但是会存在空间的浪费，同时如果需要进行字符串的交换，复杂度n^2
而对于一维指针数组来说，可以节省空间，同时交换只是指针O(1)的交换，但是缺点是不能修改值</p>]]></content><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><category term="computer science" /><category term="c program language" /><category term="pointer" /><summary type="html"><![CDATA[C语言拾遗--指针与引用]]></summary></entry><entry><title type="html">why computer science are different?</title><link href="https://h-wardell.github.io/posts/2025/07/blog-post-1/" rel="alternate" type="text/html" title="why computer science are different?" /><published>2025-07-21T00:00:00+00:00</published><updated>2025-07-21T00:00:00+00:00</updated><id>https://h-wardell.github.io/posts/2025/07/blog-post-1</id><content type="html" xml:base="https://h-wardell.github.io/posts/2025/07/blog-post-1/"><![CDATA[<p>CS和别的学科最大的一点不同就是它的开源开放。来看看Debian是怎么说的吧。</p>
<blockquote>
  <p>这全部都是免费的吗？
您也许会奇怪：为什么人们愿意花费他们自己的时间来写软件，谨慎地包装它，然后再把它全部送给别人？正如同有许多不同的人选择做出这样子的贡献一样，这个问题也有许多不同的答案。有些人只是喜欢帮助别人。有些人利用写程序来学习更多关于计算机方面的知识。也有些人是在寻找一种避免软件价格膨胀的途径。还有越来越多的人是为了对他们从其他人的自由软件中得到的好处表达谢意。在学术界中，有许多人创作自由软件来确保有更多人能够从他们的研究成果中得到好处。在商业界中，也有人利用协助维护自由软件的机会来确保他们在软件发展的过程中占有一席之地——当您需要某些新功能时，没有比自己动手做要来得更快的方法了。当然，我们之中也有许多人纯粹只是觉得这样十分的好玩。由于 Debian 对自由软件有着郑重的承诺，因此我们觉得我们应该把这样的承诺化为一份正式的文档。这就是我们“Debian 社群契约”的由来。</p>
</blockquote>

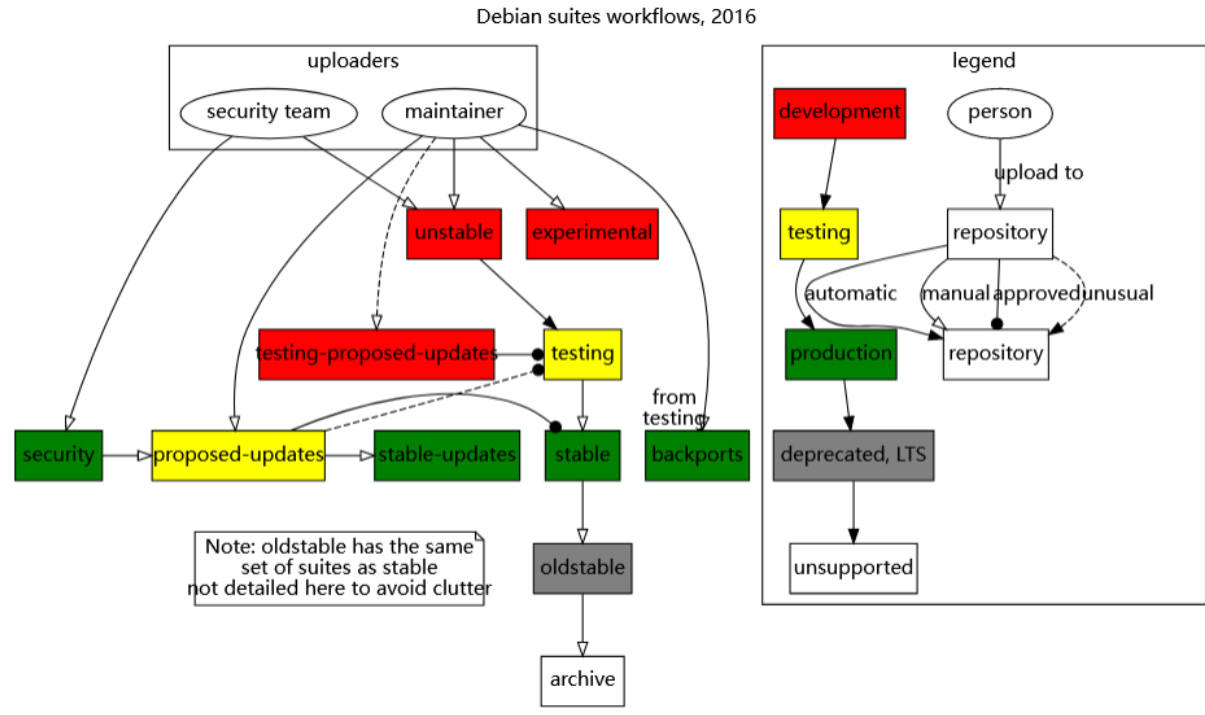
<p><img src="/images/debian-suite-workflow.jpg" alt="debian-suite-workflow.jpg" /></p>

<p>因此，软件的供应链由此诞生。
上游软件开发团队当中的security team和maintainer负责update软件的feature,repair软件的vulnerability以及testing.</p>

<p>相比于微软的帝国，开源生态就此而生。</p>

<p>但开源生态并非一个乌托邦，开源意味着每一个普通人都有机会成为这个大生态当中的Contributor,那么自然会有些不怀好意的attacker,去攻击，破坏这个生态，以此牟利。
具体来说，我们都有过使用Linux安装软件的经历。</p>

<p>Q: <code class="language-plaintext highlighter-rouge">apt</code>和<code class="language-plaintext highlighter-rouge">dpkg</code>的区别是什么(从dependency的角度)？ <br />
<code class="language-plaintext highlighter-rouge">apt</code>是一个更高级的包管理工具，它的作用是直接安装，会自动解决包的依赖问题
<code class="language-plaintext highlighter-rouge">dpkg</code>只能直接安装卸载包，而不能处理缺失的依赖。</p>]]></content><author><name>Ziqi Huang</name><uri>https://h-wardell.github.io/butterflyblog/</uri></author><category term="computer science" /><category term="open source" /><category term="software" /><summary type="html"><![CDATA[CS和别的学科最大的一点不同就是它的开源开放。来看看Debian是怎么说的吧。 这全部都是免费的吗？ 您也许会奇怪：为什么人们愿意花费他们自己的时间来写软件，谨慎地包装它，然后再把它全部送给别人？正如同有许多不同的人选择做出这样子的贡献一样，这个问题也有许多不同的答案。有些人只是喜欢帮助别人。有些人利用写程序来学习更多关于计算机方面的知识。也有些人是在寻找一种避免软件价格膨胀的途径。还有越来越多的人是为了对他们从其他人的自由软件中得到的好处表达谢意。在学术界中，有许多人创作自由软件来确保有更多人能够从他们的研究成果中得到好处。在商业界中，也有人利用协助维护自由软件的机会来确保他们在软件发展的过程中占有一席之地——当您需要某些新功能时，没有比自己动手做要来得更快的方法了。当然，我们之中也有许多人纯粹只是觉得这样十分的好玩。由于 Debian 对自由软件有着郑重的承诺，因此我们觉得我们应该把这样的承诺化为一份正式的文档。这就是我们“Debian 社群契约”的由来。]]></summary></entry></feed>